شکی نیست که فناوری تولیدی AI (Genai) پتانسیل قابل توجهی برای بخش اجتماعی دارد. با این حال ، چالش واقعی این است: چگونه محصول AI ساخته شده است که هر دو است از نظر فنی موثر وت از نظر اجتماعی؟
این ممکن است دلسرد کننده به نظر برسد ، به خصوص برای سازمان های غیر انتفاعی در ابتدای سفر فناوری خود. و با این حال ، همانطور که گرگ بروکمن ، بنیانگذار Openai می گوید ، “Evals به طور شگفت آور اغلب هر آنچه شما نیاز داریدs
اما در زمینه هوش مصنوعی برای تأثیرات اجتماعی ، ارزیابی دقیقاً به چه معنی است؟
از آنجا که شرکای ما شروع به ساختن ابزارهای تأثیر اجتماعی Genai کردند ، ما متوجه شدیم که ذینفعان مختلف به طرق مختلف به این سؤال پاسخ می دهند. برای مهندسان مانند Brockman ، ارزیابی ها سریع و به سمت مدلهای بزرگ زبان گرا هستند. در مقابل ، برای همکاران ما در اقتصاد توسعه ، ارزیابی ها معمولاً به معنای مطالعات کامل مانند تست های کنترل شده تصادفی (RCT) است.
هر دو رویکرد با ارزش هستند ، اما به طور فزاینده ای مشخص است که هیچ یک از آنها به خودی خود کافی نیست. در بخش اجتماعی ، ارزیابی نمی تواند در اندازه گیری صحت مدل متوقف شود – باید به یک سؤال بزرگتر پاسخ دهد: آیا محصولات یا خدمات Genai منجر می شوند یک تغییر مثبت و قابل اندازه گیری در زندگی افراد در مقیاس؟ در عین حال ، ارزیابی نباید یک تمرین یک زمان باشد تا بررسی کند که برنامه “کار می کند”.
با ظهور Genai ، ما معتقدیم که تغییر در الگوی ارزیابی بخش اجتماعی مورد نیاز است. ما آینده ارزیابی را به عنوان یک چرخه سریع و فعلی اجرای ، سازگاری و بهبود می بینیم – رویکردی که در آن هر ارزیابی هم یک سنگ پایه و هم یک درس است.
برای کمک به بخش اجتماعی با این الگوی جدید ، ما یک را آزاد می کنیم کتاب زندگی ارزیابی هوش مصنوعی در بخش اجتماعیاو به درسهایی از کار ما با سازمان های غیر انتفاعی ، تأمین مالی ، سیاستمداران و پزشکان هوش مصنوعی متکی است – از جمله ما AI برای توسعه جهانی (AI4GD) شتاب دهنده با OpenAI و مرکز توسعه جهانی (CGD). ما امیدواریم که این امر به عنوان یک راهنمای عملی و در حال توسعه تیم ها و استقرار ابزاری برای ژنرال ها در بخش هایی مانند آموزش ، بهداشت ، کشاورزی ، معیشت و موارد دیگر باشد.
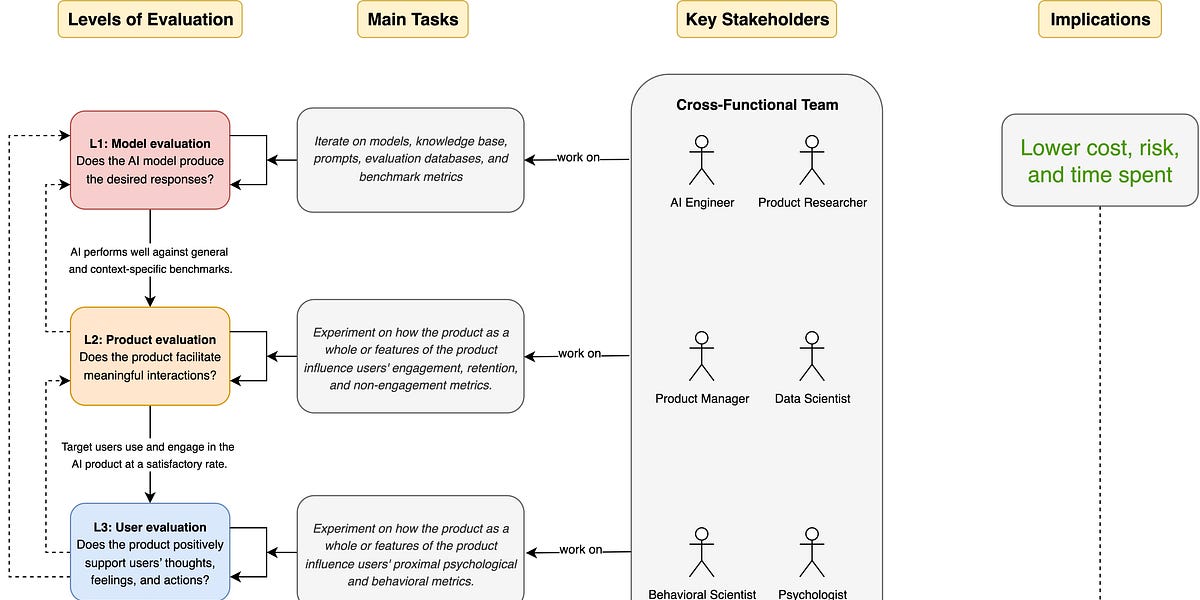
Playbook یک قاب رتبه بندی AI چهار سطح در بخش اجتماعی را معرفی می کند و ما را به روز می کند پست وبلاگ با CGD و J-Pal. در حالی که چهار سطح تکراری هستند ، آنها از پیشرفت طبیعی پیروی می کنند:
-
سطح 1 – مدل ارزیابی: آیا مدل AI پاسخ های مورد نظر را تولید می کند؟
-
سطح 2 – محصول ارزیابی: آیا محصول برای تعامل معنی دار آسانتر می شود؟
-
سطح 3 – کاربر ارزیابی: آیا محصول افکار ، احساسات و اقدامات مصرف کنندگان را به طور مثبت حفظ می کند؟
هر سطح با جنبه دیگری از ارزیابی هوش مصنوعی سروکار دارد و وظایف مختلف و ذینفعان را درگیر می کند (شکل را ببینید). در کار ما با هشت سازمان غیر انتفاعی از طریق شتاب دهنده AI4GDما در حال حاضر می بینیم که چگونه این رویکرد به تیم ها کمک می کند تا سیستم های هوش مصنوعی خود را ارزیابی کنند – با تمرکز بر آنچه که از نظر فنی ممکن است و از نظر اجتماعی با ارزش است.

ما در نظر داشتیم که راهنماهای بالا را با چشم انداز از پایین به بالا تعادل برقرار کنیم ، از جمله بینش های عملی سازمان های شتاب دهنده خود. Playbook منعکس کننده آنچه تاکنون آموخته شده است ، از جمله:
-
روش عمل برای ارزیابی هوش مصنوعی در هر چهار سطح (مدل ، محصول ، کاربر و تأثیر)
-
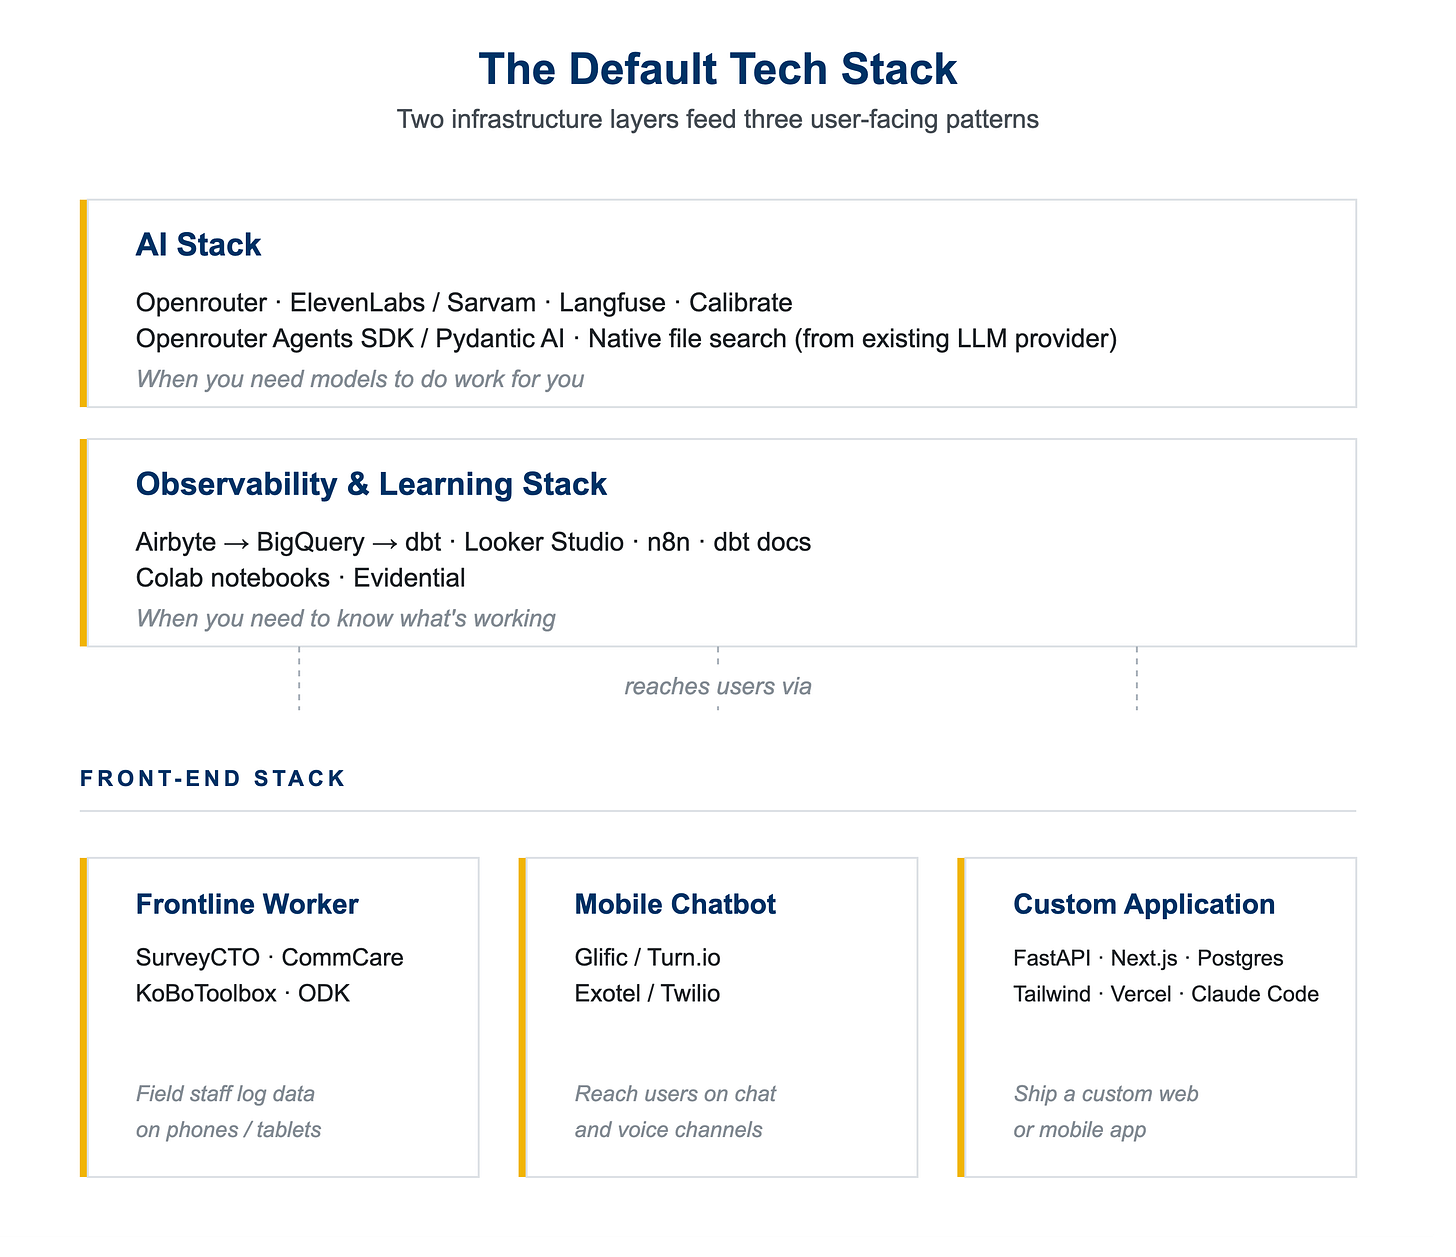
راهنمای گام به گام برای ساختن زیرساخت های دیجیتالی خود – از قیف های کاربر (نقشه برداری از نحوه حرکت کاربران از طریق محصول شما) به خطوط لوله ETL (استخراج ، تبدیل و شارژ داده ها)
-
واقعا برای همکاری چند منظوره
-
حرکات مکرر برای ایجاد این رویکرد ارزیابی در بخشی جدایی ناپذیر از توسعه محصول
اگرچه از نظر فنی ، Playbook در سطح بالایی قرار دارد اما ما نیز در حال ساخت ابزارهای عملی هستیم تا به سازمان های بخش اجتماعی کمک کنیم تا از این رویکرد استفاده کنند. ما اخیراً منتشر کرده ایم شواهدپلت فرم اتوماسیون آزمایش ، به طور مشترک با آموزش موشک و IdInsight توسعه یافته است. ما همچنین یک پلت فرم ارزیابی AI United AI را با Project Tech4Dev تهیه می کنیم ، که به تیم ها کمک می کند تا تغییرات را ثبت کنند ، کارآیی را تحت نظر داشته باشند و بر اساس شواهد مدیریت محصول هوش مصنوعی تصمیم گیری کنند.
بخش اجتماعی فرصتی برای مدیریت توسعه AI مسئول دارد. اما این امر مستلزم آوردن ذینفعان مختلف – از مهندسین ، مدیران محصول و محققان رفتاری گرفته تا بودجه و سیاستمداران – در اطراف یک زبان ارزیابی مشترک است. این بازی زنده اولین سهم ما در این تلاش است.
ما اکنون آن را شروع می کنیم – نه به این دلیل که تمام شده است ، بلکه به این دلیل که ما اطمینان داریم که در حال حاضر کار می کند. این به شرکای غیر انتفاعی ما کمک می کند تا ابزارهای بهتری را طراحی کنند ، سؤالات بیشتری بپرسند و منجر به تأثیر قابل اندازه گیری شوند. ما همچنان به توسعه کتابی برای مشارکت شرکای خود در محافل توسعه جهانی ، فناوری و دانشگاهی ادامه خواهیم داد – ما مشتاقانه منتظر اشتراک و آموزش از این جامعه رو به رشد هستیم
📘 کتاب بازی زنده را کاوش کنید از ما وب سایت یا بارگیری [PDF]حرف
افکار خود را به اشتراک بگذارید: ما از این طریق بررسی های شما را دوست داریم فرم بازخوردیا اگر علاقه مند به همکاری و منبع آزاد دانش خود هستید و در ارزیابی هوش مصنوعی کار می کنید ، فقط خود را به عنوان یک همکار معرفی کنید.
توجه : این مطلب از منابع غیر فارسی به فارسی ترجمه شده است و ممکن است شامل خطا و ایردات ترجمه ای باشد !